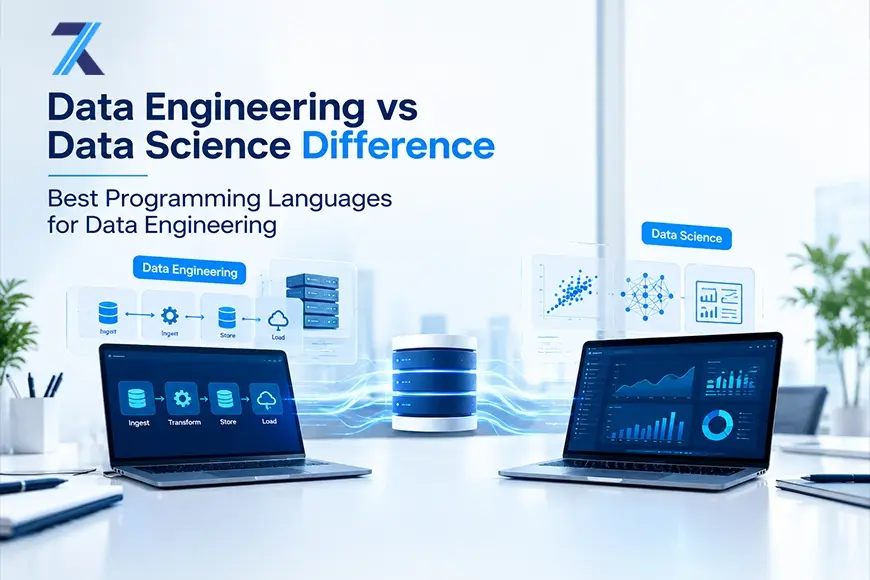
Data Engineering und Data Science sind unterschiedliche Bereiche innerhalb desselben Datenlebenszyklus. Data Engineers entwickeln und warten die Systeme, die Daten erfassen, speichern, bereinigen und zuverlässig bereitstellen. Data Scientists nutzen diese Daten, um Muster zu erkennen, Hypothesen zu prüfen, Prognosemodelle zu entwickeln und Entscheidungen zu unterstützen.
Vereinfacht gesagt: Data Engineering macht Daten nutzbar, während Data Science sie für konkrete geschäftliche Fragestellungen wertvoll macht. Die beiden Rollen überschneiden sich bei bestimmten Werkzeugen und Fähigkeiten. Ihre Hauptaufgaben, Ergebnisse und Erfolgskriterien unterscheiden sich jedoch deutlich.
Diese Unterscheidung ist wichtig, wenn Sie eine berufliche Laufbahn planen, ein Team zusammenstellen oder entscheiden müssen, welcher Schritt in einem Datenprojekt zuerst erforderlich ist. Ein Data Scientist kann zwar ein Modell entwickeln, doch dieses Modell ist nur schwer vertrauenswürdig, wenn die zugrunde liegenden Daten unvollständig oder inkonsistent sind. Umgekehrt kann ein Data Engineer eine hervorragende Datenpipeline erstellen, doch das Unternehmen benötigt zusätzlich eine fundierte Analyse, um die Bedeutung der Daten zu verstehen und geeignete Maßnahmen abzuleiten.
Bei 7 Kings Code steht Ihnen ein Team erfahrener Data Engineers zur Seite, von der ersten Planung bis zur langfristigen Weiterentwicklung Ihrer Datenlösungen.
Was macht ein Data Engineer?
Ein Data Engineer entwickelt die technische Grundlage, die es einem Unternehmen ermöglicht, Daten konsistent zu nutzen. Daten können aus Anwendungen, Websites, Zahlungssystemen, Sensoren, Kundensupport-Tools oder externen Quellen stammen. Diese Quellen verwenden häufig unterschiedliche Formate und werden zu unterschiedlichen Zeitpunkten aktualisiert. Data Engineers entwickeln Prozesse, die diese Daten zusammenführen.
Zu den typischen Aufgaben gehören:
- Entwicklung und Wartung von Datenpipelines
- Integration verschiedener Datenquellen
- Aufbau und Gestaltung von Datenbanken und Data Warehouses
- Umwandlung von Rohdaten in nutzbare Tabellen und Datensätze
- Überwachung von Datenverarbeitungsprozessen
- Verbesserung der Systemleistung
- Verwaltung von Zugriffsrechten und Sicherheitsmaßnahmen
Dabei kann es sich um Batch-Verarbeitung handeln, bei der Daten nach einem festen Zeitplan verarbeitet werden. Eine weitere Möglichkeit ist Streaming, bei dem Informationen unmittelbar während ihrer Entstehung verarbeitet werden.
Data Engineers achten außerdem besonders auf Zuverlässigkeit. Eine Pipeline, die nur einmal funktioniert, reicht nicht aus. Sie muss auch dann stabil laufen, wenn das Datenvolumen wächst, sich das Format einer Quelle verändert, ein Prozess ausfällt oder ein anderes Team Zugriff auf die Daten benötigt. Deshalb integrieren Data Engineers Tests, Warnmeldungen, Dokumentationen und Wiederherstellungsprozesse. So können nachgelagerte Nutzer und Systeme dauerhaft auf die Daten vertrauen.
Zu den möglichen Ergebnissen ihrer Arbeit gehören:
- ein cloudbasiertes Data Warehouse
- ein automatisierter Prozess für Extraktion und Transformation
- ein bereinigter Kundendatensatz
- Prüfungen der Datenqualität
- eine Echtzeit-Pipeline für Ereignisdaten
- eine dokumentierte Datenarchitektur
Die zentrale Frage lautet meist: Erreichen die richtigen Daten zuverlässig, sicher und effizient den richtigen Ort?
Was macht ein Data Scientist?
Ein Data Scientist arbeitet mit Daten, um geschäftliche oder wissenschaftliche Fragen zu beantworten. Dabei kann es beispielsweise darum gehen, herauszufinden, warum Kunden kündigen, die zukünftige Nachfrage zu schätzen, ungewöhnliche Transaktionen zu erkennen, Produkte zu empfehlen, die Wirkung einer Kampagne zu messen oder Fälle zu identifizieren, die besondere Aufmerksamkeit benötigen.
Die Arbeit beginnt in der Regel mit der Definition des Problems und einer ersten Untersuchung der Daten. Data Scientists prüfen die verfügbaren Daten, bewerten ihre Qualität, suchen nach Zusammenhängen und entscheiden, ob die Daten die jeweilige Fragestellung überhaupt beantworten können.
Je nach Aufgabe kommen unterschiedliche Methoden zum Einsatz:
- Deskriptive Statistik, um vergangene Entwicklungen zu beschreiben
- Inferenzstatistik, um Hypothesen zu prüfen
- Machine Learning, um wahrscheinliche zukünftige Ergebnisse vorherzusagen
Data Scientists erstellen Merkmale (Features) für ihre Modelle, trainieren und bewerten Modelle, vergleichen verschiedene Ansätze, führen Experimente durch und kommunizieren ihre Ergebnisse. Ebenso wichtig ist es, die Grenzen der eigenen Arbeit zu verstehen. Ein Modell kann einen starken Zusammenhang zeigen, ohne zu beweisen, dass ein Faktor tatsächlich die Ursache für einen anderen ist. Eine Vorhersage kann auf historischen Daten sehr genau sein und dennoch schlechter funktionieren, wenn sich das Verhalten der Kunden verändert.
Mögliche Ergebnisse der Arbeit eines Data Scientists sind:
- ein Analysebericht
- eine Prognose
- eine Methode zur Kundensegmentierung
- ein Versuchsdesign
- ein Empfehlungsmodell
- ein Risikoscore
- eine Präsentation für Entscheidungsträger
Die zentrale Frage lautet meist: Was sagen uns die Daten, was könnte als Nächstes passieren und wie sollte das Unternehmen dieses Wissen nutzen?
Die wichtigsten Unterschiede zwischen Data Engineering und Data Science
Der deutlichste Unterschied liegt in der Ausrichtung der Arbeit. Data Engineering ist grundsätzlich infrastrukturell orientiert und findet eher am Anfang des Datenlebenszyklus statt. Data Science ist stärker analyseorientiert und nutzt vorbereitete Daten, um Probleme zu untersuchen und Erkenntnisse zu gewinnen.
Ein Data Engineer konzentriert sich unter anderem auf:
- Skalierbarkeit
- Verfügbarkeit
- Systemleistung
- Datenqualität
- Sicherheit
Ein Data Scientist beschäftigt sich stärker mit:
- Mustern
- Unsicherheit
- Modellqualität
- Prognosen
- Experimenten
- Interpretation
Data Engineers entwickeln häufig Systeme und Datensätze. Data Scientists erstellen eher Analysen, Modelle und Handlungsempfehlungen.
Auch der zeitliche Horizont kann unterschiedlich sein. Engineering-Aufgaben sind oft kontinuierlich, da Datenpipelines und Plattformen regelmäßig gewartet und weiterentwickelt werden müssen. Data-Science-Projekte sind dagegen häufig explorativ und iterativ. Sie beginnen mit einer Frage, führen zu einem Experiment und münden schließlich in einem Modell oder einer Empfehlung.
Ein erfolgreiches Modell kann später jedoch zusätzliche Engineering-Arbeit erfordern, damit es zuverlässig in einem Produkt oder einer Anwendung eingesetzt werden kann. Deshalb werden die Grenzen zwischen beiden Rollen in fortgeschrittenen Datenteams oft weniger eindeutig.
Auch die Erfolgskriterien unterscheiden sich:
Ein Data Engineer wird häufig anhand von Faktoren wie Pipeline-Zuverlässigkeit, Verarbeitungszeit, Aktualität der Daten, Kosten, Systemverfügbarkeit und Ergebnissen der Qualitätstests bewertet.
Bei einem Data Scientist stehen eher Modellleistung, Qualität der Experimente, Prognosegenauigkeit, geschäftliche Auswirkungen, Akzeptanz und Verständlichkeit der Empfehlungen im Mittelpunkt.
Fähigkeiten und Werkzeuge der beiden Rollen
Beide Rollen erfordern Programmierkenntnisse, Problemlösungskompetenz, Kommunikationsfähigkeit und ein grundlegendes Verständnis von Datenstrukturen. SQL ist in beiden Bereichen weit verbreitet. Data Engineers nutzen SQL, um Daten zu verwalten und umzuwandeln, während Data Scientists damit Daten abrufen und untersuchen. Auch Python kommt in beiden Bereichen zum Einsatz, wenn auch für unterschiedliche Zwecke.
Typische Fähigkeiten und Werkzeuge im Data Engineering
Data Engineers benötigen in der Regel fundierte Kenntnisse in Softwareentwicklung und Systemarchitektur. Zu ihrem Werkzeugkasten können gehören:
- SQL-Datenbanken wie PostgreSQL
- NoSQL-Systeme
- Cloud-Plattformen wie AWS, Microsoft Azure oder Google Cloud
- Technologien für verteilte Datenverarbeitung wie Apache Spark
- Apache Kafka für Event-Streaming
- Apache Airflow oder ähnliche Werkzeuge zur Planung und Überwachung von Workflows
- ETL- und ELT-Werkzeuge
- Infrastructure as Code
- Container-Technologien
- Versionskontrollsysteme
- Systeme für Data Governance
Typische Fähigkeiten und Werkzeuge in der Data Science
Data Scientists benötigen meist fundierte Kenntnisse in Statistik, Mathematik, Versuchsplanung und Machine Learning. Häufig verwendete Werkzeuge sind:
- Python oder R
- Pandas
- NumPy
- scikit-learn
- TensorFlow
- PyTorch
- Jupyter
- Matplotlib
- Seaborn
- Tableau
- Power BI
Diese Werkzeuge helfen dabei, Daten zu analysieren, Modelle zu entwickeln und Ergebnisse verständlich darzustellen. Je nach Projekt können außerdem SQL, cloudbasierte Notebooks, Werkzeuge zur Modellverfolgung sowie spezialisierte Bibliotheken für natürliche Sprachverarbeitung oder Computer Vision zum Einsatz kommen.
Diese Aufzählungen stellen keine starren Grenzen dar. Ein Data Engineer kann beispielsweise ein kleines Prognosemodell entwickeln, um eine Pipeline zu überwachen. Ein Data Scientist kann produktionsreifen Code schreiben oder eine Datentransformation entwerfen. Die Unterscheidung lässt sich daher besser über das Hauptproblem verstehen, für das eine Person verantwortlich ist, als über eine feste Liste von Programmen und Technologien.
Wie arbeiten Data Engineers und Data Scientists zusammen?
Stellen wir uns ein Einzelhandelsunternehmen vor, das die Nachfrage für jede Filiale prognostizieren möchte.
Zunächst erfassen Data Engineers historische Transaktionsdaten, Lagerbestände, Werbeaktionen, Feiertage, Wetterinformationen und Filialdaten. Sie entwickeln eine konsistente Pipeline, gleichen unterschiedliche Produktkennungen ab, entfernen doppelte Datensätze und stellen die vorbereiteten Daten in einem Data Warehouse oder einer Modellierungsumgebung bereit.
Anschließend untersucht der Data Scientist die Daten und identifiziert relevante Variablen. Er testet verschiedene Prognosemethoden, vergleicht deren Genauigkeit, analysiert Fehler und schätzt ein, wie die Vorhersagen die Lagerbestandsplanung verbessern könnten. Die Vor- und Nachteile der verschiedenen Ansätze werden anschließend dem Produkt- oder Betriebsteam erläutert.
Wenn das Unternehmen beschließt, das Modell einzusetzen, geht die Arbeit weiter. Data Engineers können einen automatisierten Prozess entwickeln, der neue Daten regelmäßig bereitstellt, Prognosen speichert, Ausfälle überwacht und die Ergebnisse an eine Anwendung oder ein Dashboard übermittelt.
Der Data Scientist überwacht möglicherweise die Modellleistung und untersucht, ob die Genauigkeit nachlässt, weil sich das Verhalten der Kunden verändert hat.
Dabei handelt es sich nicht um eine einmalige Übergabe von einer Abteilung an die andere. Data Scientists können feststellen, dass ein entscheidendes Datenfeld fehlt oder Zeitstempel unzuverlässig sind. Data Engineers müssen die Pipeline dann möglicherweise anpassen, damit die benötigten Daten in der erforderlichen Häufigkeit verfügbar sind.
Beide Rollen profitieren von klaren Definitionen, gemeinsamer Dokumentation und einer frühzeitigen Einigung über das gewünschte Geschäftsergebnis.
Welche Rolle spielt Business Intelligence?
Business Intelligence, kurz BI, steht mit beiden Bereichen in Verbindung, verfolgt jedoch einen eigenen Schwerpunkt. BI verwandelt aktuelle und historische Daten in Dashboards, Berichte und verständliche Leistungsübersichten.
Damit lassen sich beispielsweise Fragen beantworten wie:
- Wie hoch waren die Umsätze im vergangenen Monat?
- Welche Region liegt unter dem Zielwert?
- Wie verändern sich die Supportanfragen?
Data Science blickt häufig stärker in die Zukunft. Typische Fragen sind beispielsweise:
- Was wird wahrscheinlich als Nächstes passieren?
- Welche Kunden laufen Gefahr, das Unternehmen zu verlassen?
- Welcher Preis oder welche Maßnahme führt voraussichtlich zu einem besseren Ergebnis?
Diese Unterscheidung ist vereinfacht, denn Business Intelligence kann auch fortgeschrittene Analysen enthalten. Ebenso kann Data Science vergangene Entwicklungen beschreiben. Trotzdem wird BI häufig mit deskriptiver Berichterstattung verbunden, während Data Science stärker für prädiktive und präskriptive Aufgaben steht.
Data Engineering bildet die Grundlage für beide Bereiche. Data Engineers stellen die zuverlässigen Daten bereit, die Dashboards und Modelle benötigen. In manchen Unternehmen arbeiten Analytics Engineers an der Schnittstelle zwischen Engineering und BI. Sie wandeln Warehouse-Daten in klar definierte Modelle um, die Analysten und Fachanwender verstehen und nutzen können.
Kleinere Unternehmen bündeln mehrere dieser Aufgaben möglicherweise in einer Rolle. In größeren Organisationen werden die Verantwortlichkeiten häufig deutlicher getrennt.
Ausbildung und berufliche Ausrichtung
Für keine der beiden Laufbahnen gibt es einen einzigen vorgeschriebenen Studienabschluss. Die häufigsten Ausbildungshintergründe spiegeln jedoch die jeweiligen Aufgaben wider.
Data Engineers kommen oft aus den Bereichen:
- Informatik
- Softwareentwicklung
- Wirtschaftsinformatik
- Informationssysteme
- verwandte technische Studiengänge
Ihre Ausbildung konzentriert sich typischerweise auf Datenbanken, verteilte Systeme, Cloud-Infrastrukturen, Programmierung und Systemdesign.
Data Scientists haben häufig einen Hintergrund in:
- Statistik
- angewandter Mathematik
- Informatik
- Volkswirtschaftslehre
- Physik
- spezialisierten Data-Science-Studiengängen
In ihrer Ausbildung spielen Wahrscheinlichkeit, statistische Modellierung, Machine Learning, Versuchsplanung und Kommunikation meist eine zentrale Rolle. Ein weiterführendes Studium kann für forschungsorientierte Positionen hilfreich sein. Gleichzeitig sind praktische Projekte und überzeugende technische Ergebnisse ebenfalls von großer Bedeutung.
Wer gerne Systeme entwirft, Zuverlässigkeit verbessert, produktionsreifen Code schreibt und Leistungsprobleme löst, fühlt sich möglicherweise im Data Engineering besonders wohl.
Wer offene Fragestellungen, statistisches Denken, Experimente, die Entdeckung von Mustern und die verständliche Erklärung von Ergebnissen bevorzugt, könnte sich eher für Data Science interessieren.
Keine der beiden Laufbahnen ist grundsätzlich schwieriger. Engineering bringt häufig anspruchsvolle Anforderungen an Betrieb und Skalierbarkeit mit sich, während Data Science stärker durch Mehrdeutigkeit und Unsicherheit geprägt ist. Die bessere Wahl hängt daher davon ab, welche Art von Problemen eine Person gerne lösen möchte.
Häufige Missverständnisse
Data Engineering ist nicht einfach Datenbankadministration
Kenntnisse über Datenbanken sind wichtig. Modernes Data Engineering umfasst jedoch häufig auch Cloud-Architektur, Streaming, Orchestrierung, Tests, Monitoring, Sicherheit und die Verarbeitung großer Datenmengen.
Data Science besteht nicht nur aus Machine Learning
Ein guter Data Scientist verbringt möglicherweise viel Zeit damit, ein Problem zu definieren, Daten zu untersuchen, Experimente zu planen, Verzerrungen zu prüfen oder Ergebnisse zu kommunizieren. Ein komplexes Modell ist nicht automatisch besser als eine klare und verständliche Analyse.
Die beiden Rollen sind keine Konkurrenten
Eine zuverlässige Datenplattform ersetzt keine Analyse. Ebenso kann ein ausgefeiltes Modell schlechte Datengrundlagen nicht ausgleichen. Die leistungsfähigsten Datenteams verstehen die Übergabepunkte und beziehen die jeweils passenden Spezialisten frühzeitig ein.
Fazit
Data Engineering und Data Science beantworten unterschiedliche Fragen innerhalb desselben Datenlebenszyklus. Data Engineers sorgen dafür, dass Daten zuverlässig, zugänglich und einsatzbereit sind. Data Scientists nutzen diese Daten, um Verhalten zu erklären, Entwicklungen vorherzusagen und bessere Entscheidungen zu unterstützen.
Die Werkzeuge beider Bereiche überschneiden sich, und in kleineren Teams werden die Aufgaben möglicherweise von denselben Personen übernommen. Der grundlegende Schwerpunkt bleibt jedoch unterschiedlich: Die eine Rolle schafft die Grundlage, die andere gewinnt daraus Erkenntnisse.
Für Unternehmen lautet die praktische Schlussfolgerung: Lösen Sie zunächst das grundlegende Datenproblem, bevor Sie von fortgeschrittenen Analysen zuverlässige Ergebnisse erwarten. Die Zusammenarbeit mit Experten im Bereich Data Engineering stellt sicher, dass Ihre Systeme von Anfang an auf einer stabilen Grundlage aufbauen.
Für Einzelpersonen hängt die Entscheidung davon ab, welche Art von Arbeit sich natürlicher anfühlt: robuste Systeme zu entwickeln oder unsichere und komplexe Fragestellungen zu untersuchen.
In beiden Fällen entstehen die besten Ergebnisse, wenn Data Engineering und Data Science partnerschaftlich zusammenarbeiten – und nicht als getrennte Abteilungen, die unvollständige Arbeit einfach weiterreichen.